Streamlit
Sentiment analyzer
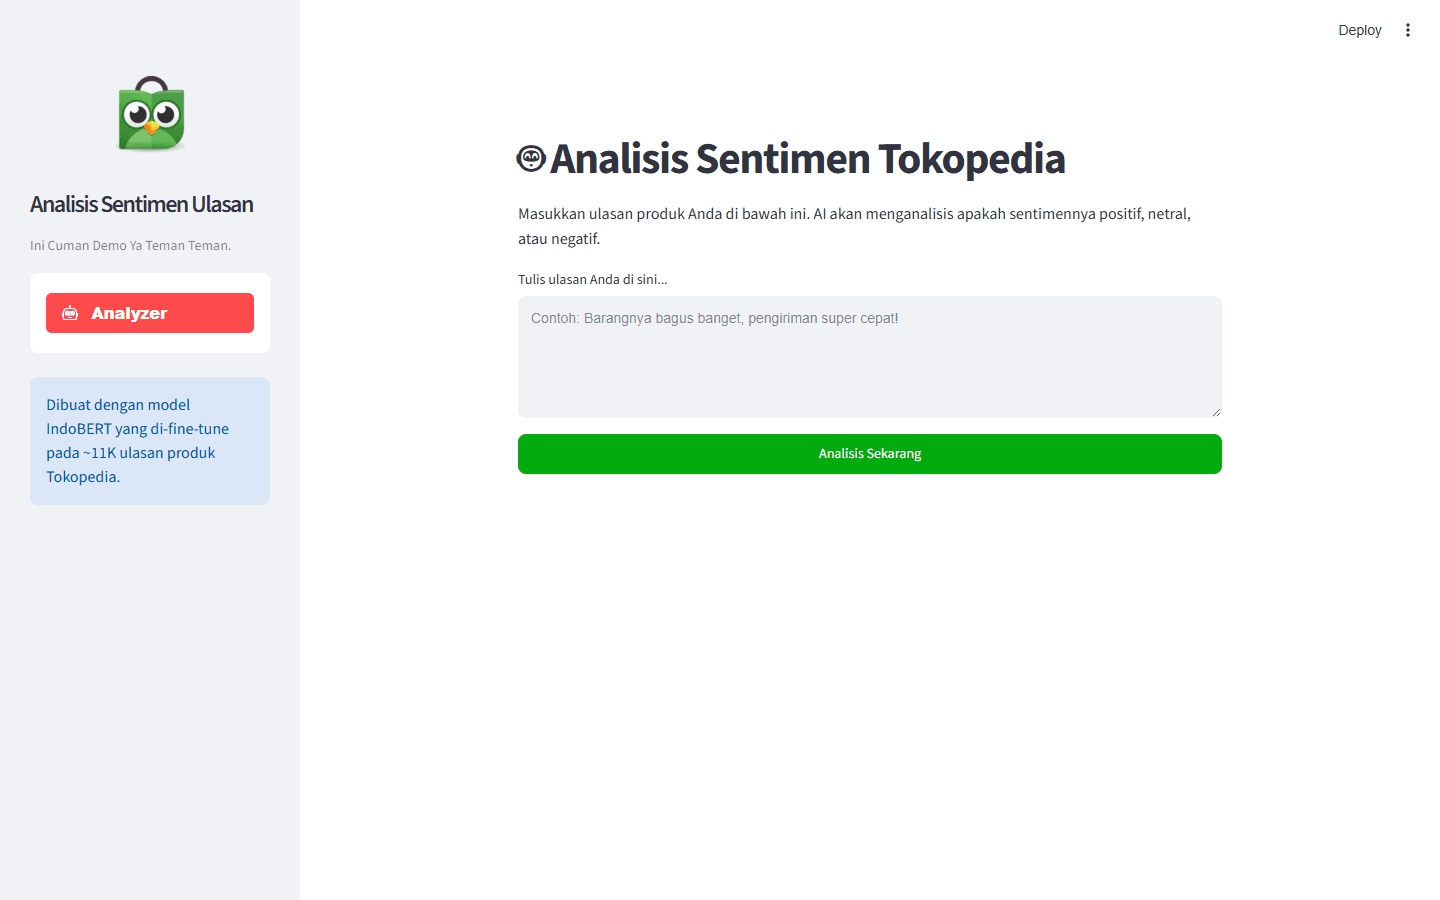
Aplikasi Streamlit yang menerima ulasan untuk diklasifikasikan oleh pipeline IndoBERT.
Studi kasus · 08 / 08
Mengubah ribuan ulasan menjadi sinyal yang bisa dibaca.
Eksperimen NLP untuk mengklasifikasikan ulasan marketplace ke sentimen positif, netral, dan negatif menggunakan IndoBERT, lengkap dengan confidence score dan aplikasi Streamlit.
Pencapaian utama
Mengklasifikasikan ulasan marketplace berbahasa Indonesia dengan IndoBERT, lengkap dengan confidence score.
01 · Konteks
Pengguna utama
Masalahnya
Volume ulasan produk terlalu besar untuk dibaca satu per satu. Rating bintang juga tidak selalu menangkap konteks bahasa, keluhan, atau nada netral dalam teks Indonesia.
Pendekatannya
Pipeline menyiapkan data ulasan, melakukan tokenisasi, menjalankan model IndoBERT, lalu mengembalikan kelas sentimen beserta confidence score melalui antarmuka Streamlit.
Angka kunci
02 · Peran saya
Data & ML Engineer
Teknologi yang digunakan
Menyiapkan dan melabeli data ulasan untuk tiga kelas sentimen.
Melakukan fine-tuning dan inferensi model IndoBERT.
Membungkus model dalam aplikasi Streamlit yang menampilkan kelas dan confidence score.
Mengelola model dan dataset berukuran besar lewat Git LFS.
03 · Sorotan
Klik gambar untuk melihatnya lebih besar.
Geser untuk melihat semua, ketuk gambar untuk memperbesar.
Aplikasi Streamlit yang menerima ulasan untuk diklasifikasikan oleh pipeline IndoBERT.
04 · Tantangan & keputusan
01 / 02
05 · Hasil
Hasil klasifikasi dapat dipakai sebagai fondasi untuk memantau kecenderungan feedback, memprioritaskan keluhan, dan menemukan tema yang perlu dianalisis lebih lanjut.
Alur penggunaan
Arsitektur
Data
review samples · label sentimen · preprocessing notebook
Model
IndoBERT tokenizer · PyTorch weights · three-class classifier
Inference
text input · tokenization · logits · softmax confidence
Interface
Streamlit app untuk eksplorasi prediksi
Model data
Review
text
rating
source
created_at
Label
review_id
sentiment
split
Model Artifact
checkpoint
tokenizer
version
Prediction
review_id
model_version
class
confidence